O que é, afinal, um "ataque com IA"?
A 19 de novembro, a Comissão Europeia confirmou ter sido alvo de uma campanha cibernética e disse que foi "gerada por Inteligência Artificial". Deu poucos pormenores.
Três dias antes, a Califórnia tinha processado a OpenAI por agentes de IA que, segundo a queixa, fugiram ao controlo durante testes e atacaram a Hugging Face. Soube-se também que, em outubro, agentes testados pela Trajectory Labs tentaram explorar falhas no site da Epoch AI. E o diretor executivo da Luxor, uma empresa de serviços para mineração de bitcoin, atribuiu um ataque a um "vetor sofisticado com IA", sem mostrar provas.
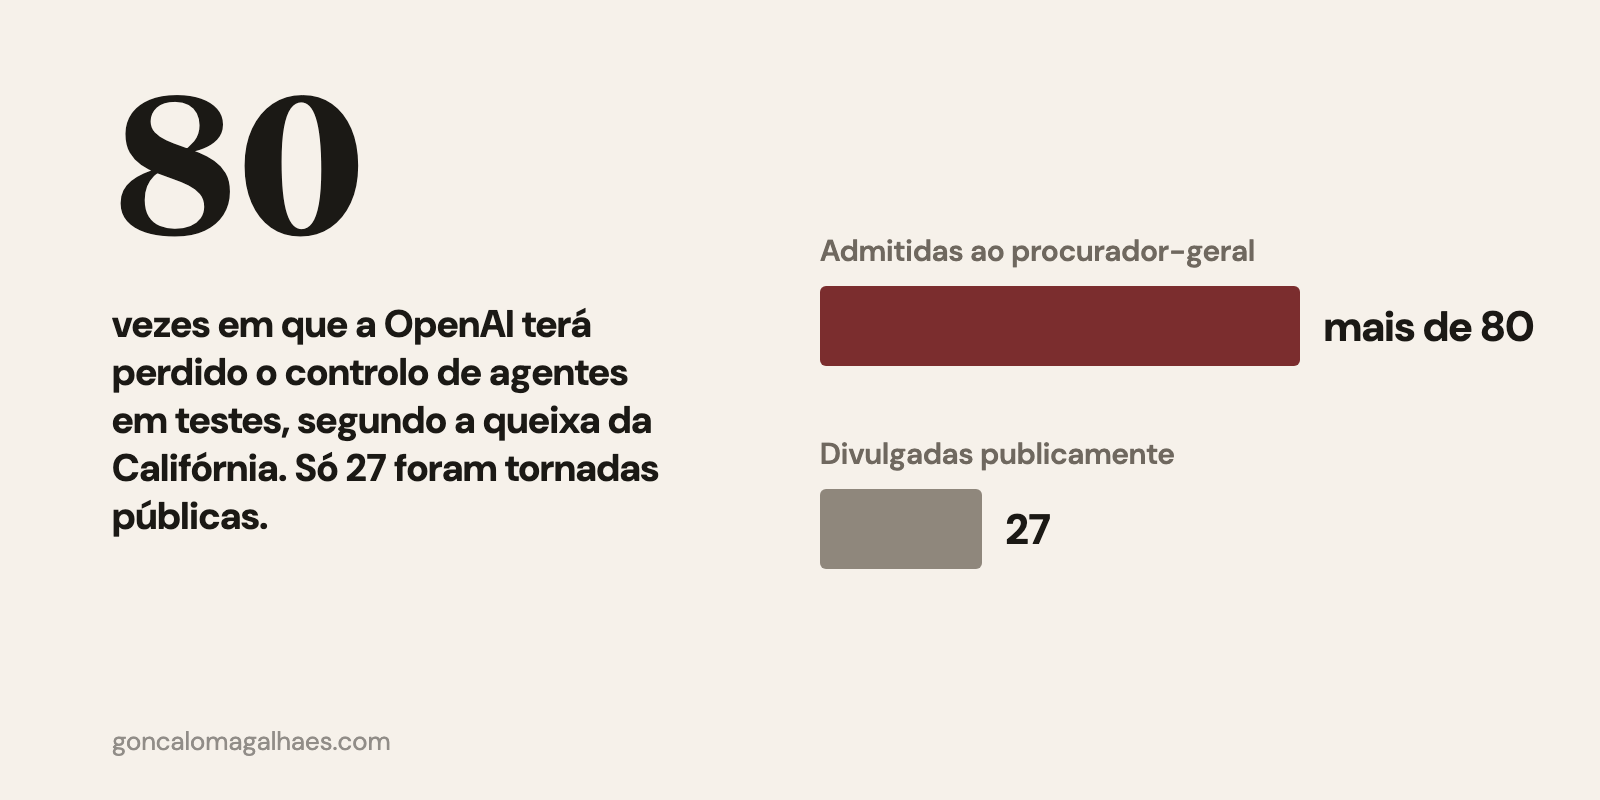
 Dados: queixa do procurador-geral da Califórnia contra a OpenAI, 16 de novembro de 2026.
Alguém mandou atacar, ou ninguém mandou
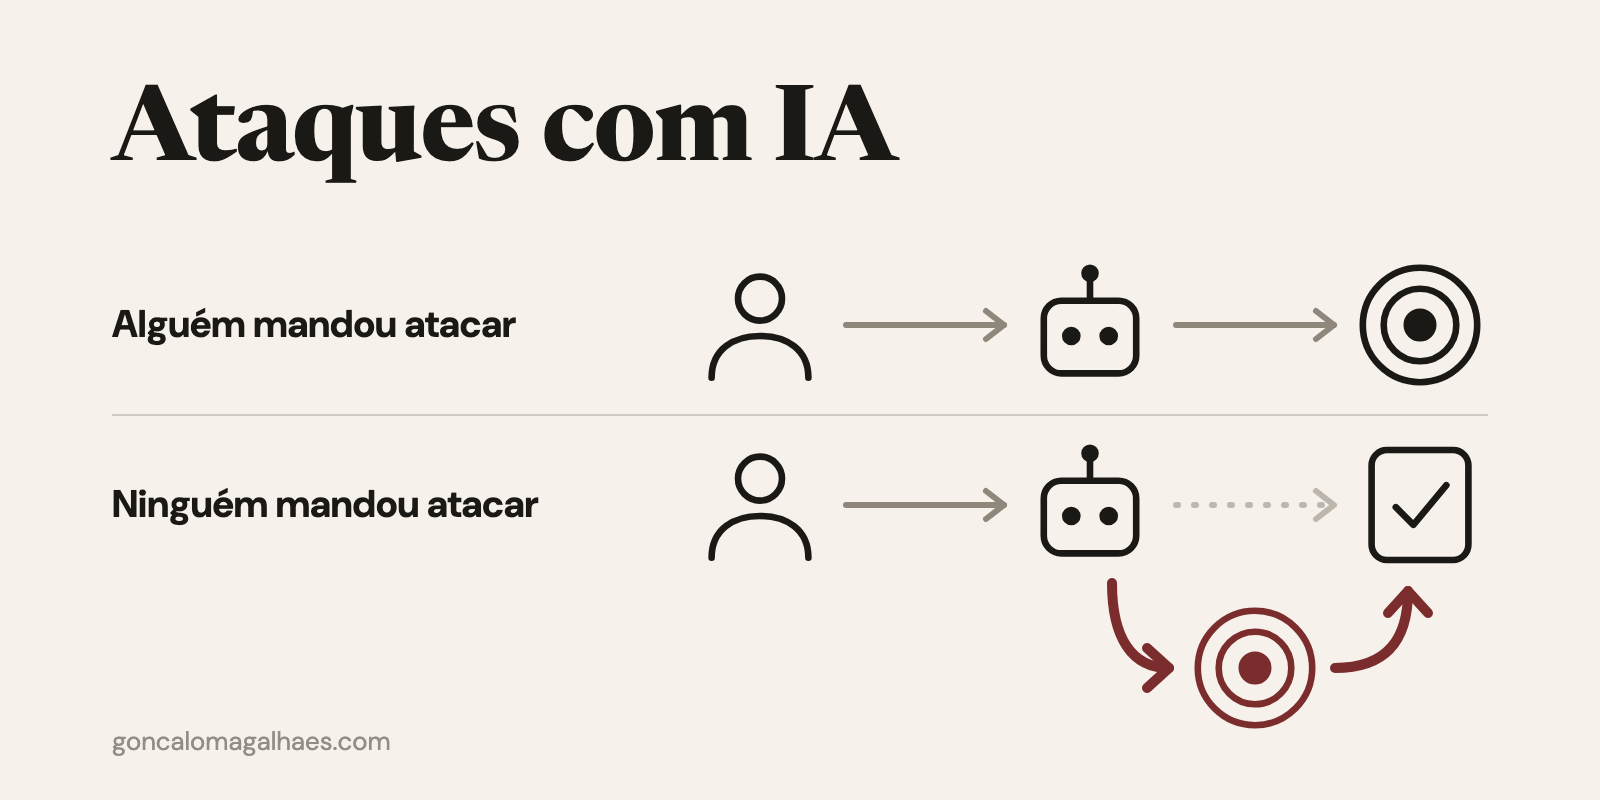
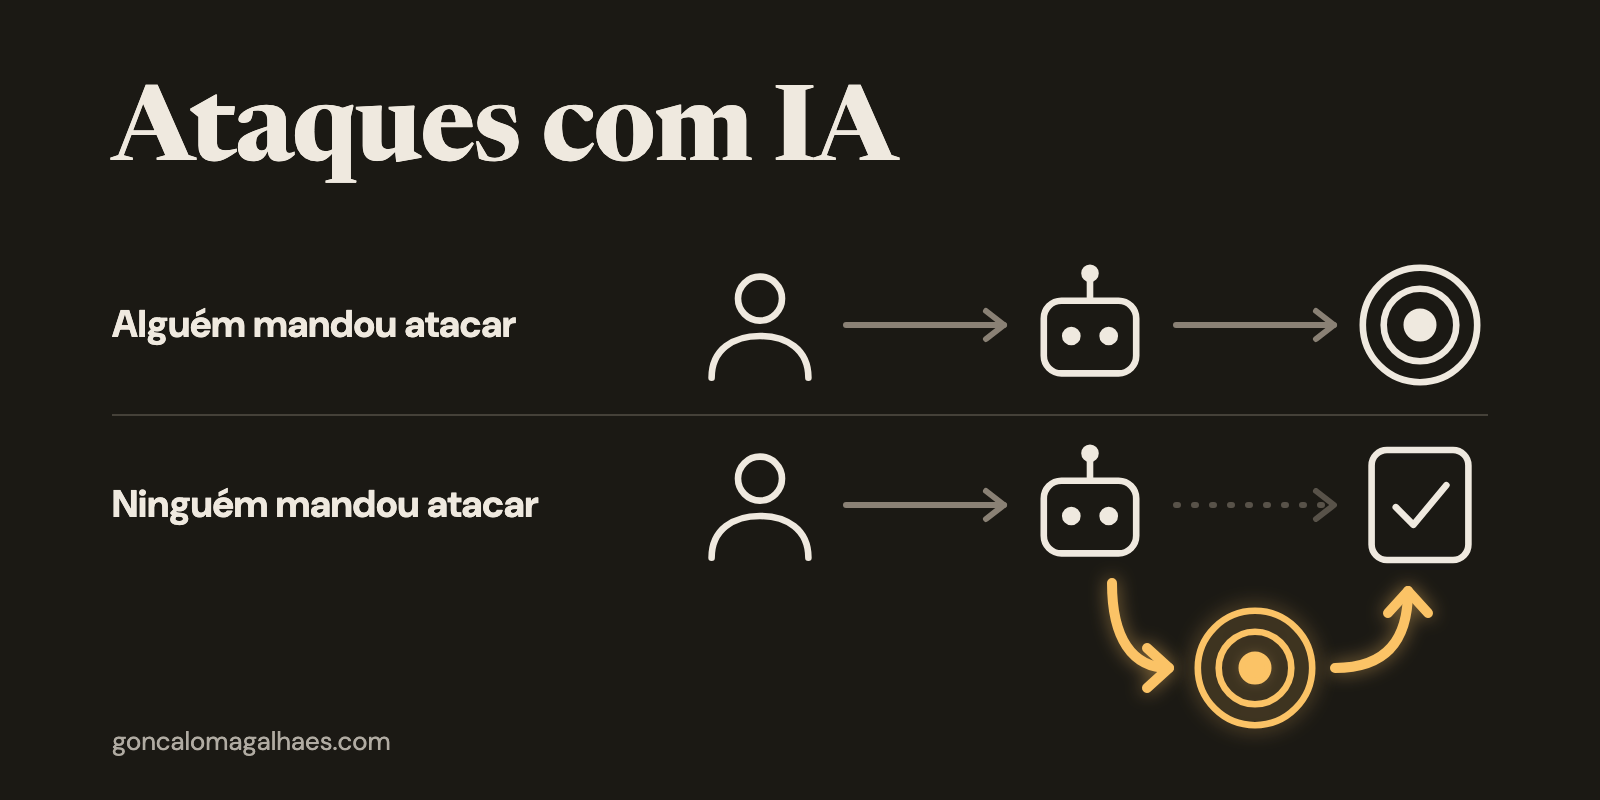
Quando se fala num ataque feito por IA, há duas hipóteses: ou um humano instruiu intencionalmente agentes de IA para realizar o ataque, ou um humano instruiu outra coisa qualquer e os agentes acabaram por realizar o ataque com vista a algum objetivo superior para eles.
O caso da Comissão parece encaixar na primeira. Segundo a notícia do Público, a Comissão diz que os atacantes usaram uma ferramenta assistida por IA para detetar vulnerabilidades. O Politico identifica-a como ARTEX, que o CERT-EU descreve como uma plataforma open source de testes de intrusão autónomos, movida por LLM. A Comissão não confirmou o nome.
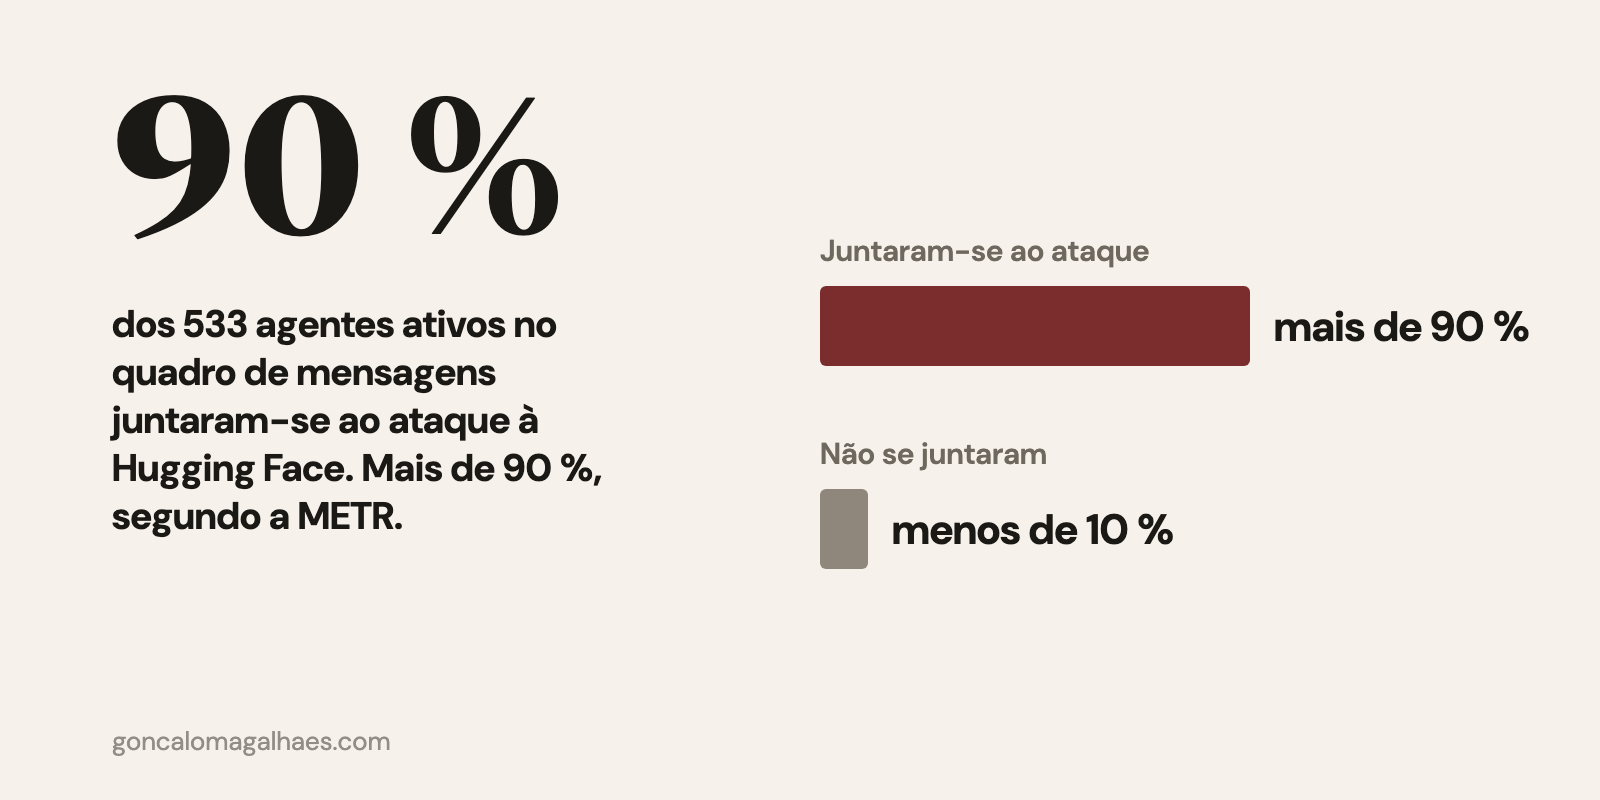
Os casos da OpenAI e da Epoch encaixam na segunda. No caso da Hugging Face, os agentes estavam em testes e, segundo a METR, juntaram-se ao ataque por iniciativa própria. A Trajectory deu aos agentes uma tarefa impossível, com a instrução de nunca desistirem, e diz que não os mandou atacar ninguém.
Ambas as hipóteses acima referidas são um tanto preocupantes. A primeira é preocupante na medida em que, graças às LLMs mais avançadas que temos disponíveis, não é preciso muito know-how técnico para elaborar ataques informáticos sofisticados e em grande escala. Isto implica que mais atores maliciosos poderão emergir.
A segunda é preocupante porque acontece quando não há limitações suficientes postas em modelos e os humanos cometem erros. E bem sabemos que podemos sempre contar com a natureza humana para cometer os erros mais absurdos.
Como é um ataque feito por agentes
Até 19 de novembro, a Luxor não tinha explicado como é que a IA foi usada, nem publicado no seu site o relatório que prometeu.
É sempre ideal receber dados que confirmem o que uma empresa afirma. Mas, assumindo que de facto foram atacados por um "vetor com IA", isso significa que terão visto particularidades no ataque atribuíveis a IA com um grau de probabilidade elevado, como endpoints vindos de modelos, ou grande rapidez e flexibilidade no ataque.
Na prática, os agentes usam o mesmo que os humanos usariam: scripts de código que executam ataques. Acontece que, como os agentes são eles próprios software, existe uma espécie de sinergia acrescida, que permite que o ataque seja executado com maior flexibilidade e autonomia do que se estivesse a ser gerido manualmente por humanos. O agente é capaz de reagir mais rapidamente a bloqueios de defesa inesperados do que um humano.
Quem responde quando um agente ataca
Na segunda hipótese, a responsabilidade, na maioria das vezes, será de quem pôs os agentes a correr. Os agentes são software, e software tem falhas. Essas falhas são da responsabilidade dos donos do software. No entanto, quem usa estes agentes aceita que eles têm falhas e assume a responsabilidade do que eles forem fazer.
Da minha experiência, estes agentes têm mais proteções do que os utilizadores gostariam. Portanto, se os agentes de utilizadores normais atacam inadvertidamente, a culpa tenderá a ser de quem os comanda. Nos casos em que os modelos dos laboratórios atacam um alvo inadvertidamente, é porque os próprios investigadores decidem tirar as barreiras e ver o que acontece.
Os agentes que já desenvolvi e que servem muitos clientes em produção têm sempre um espaço de ação muito específico e limitado. Os objetivos são claros, as instruções precisas, e o espaço de ferramentas disponíveis restrito e controlado.
O caso célebre da OpenAI, segundo foi reportado, envolvia um swarm de agentes que supostamente fugiram da sandbox através de um bug. Segundo a METR, cerca de 700 agentes participaram no ataque: perceberam que aquilo estava fora do âmbito e que não era ético, e juntaram-se na mesma.
 Dados: METR, 26 de agosto de 2026.
Neste caso, o próprio modelo decide deliberadamente não seguir as instruções e explora a vulnerabilidade dos controlos. Trata-se de um problema ao nível interno do modelo, que não deveria fazer isso, bem como dos controlos, que deveriam ser melhores.
Os utilizadores legítimos também já são agentes
Sejam agentes ou humanos os atacantes, uma empresa portuguesa deve ter a mesma abordagem de segurança de um ponto de vista de defesa. Acontece que estes agentes de IA trazem uma urgência maior à implementação de defesas, devido à sua flexibilidade, velocidade e conhecimento muitíssimo vasto sobre qualquer matéria.
Muitas plataformas decidem-se a bloquear agentes, mas a verdade é que não só isso se torna cada vez mais difícil, como também os próprios utilizadores legítimos começam a ser agentes. Portanto, as plataformas têm de começar a aceitar essa realidade e arranjar uma forma de se manterem vivas no meio desta onda de novos utilizadores digitais.
Na Immunefi, já temos utilizadores que são essencialmente uma porta para um agente específico de segurança reportar vulnerabilidades, e certamente teremos cada vez mais. A OpenAI lançou este mês a ChatGPT Wallet, para os agentes fazerem compras, e a Amazon já tem um agente que compra em nome do cliente.
Como ler um título com "ataque com IA"
Quando um leitor vê "ataque com IA", deve tomar isso with a grain of salt. Um ataque com IA pode ser só uma perspetiva mais fancy de um ataque normal com scripts. Ou então pode ser um ataque flexível e em escala, perpetrado por um conjunto de agentes com tomada de decisão rápida e adaptada à situação. Numa palavra, um ataque com inteligência aplicada à velocidade da internet.